
 admin
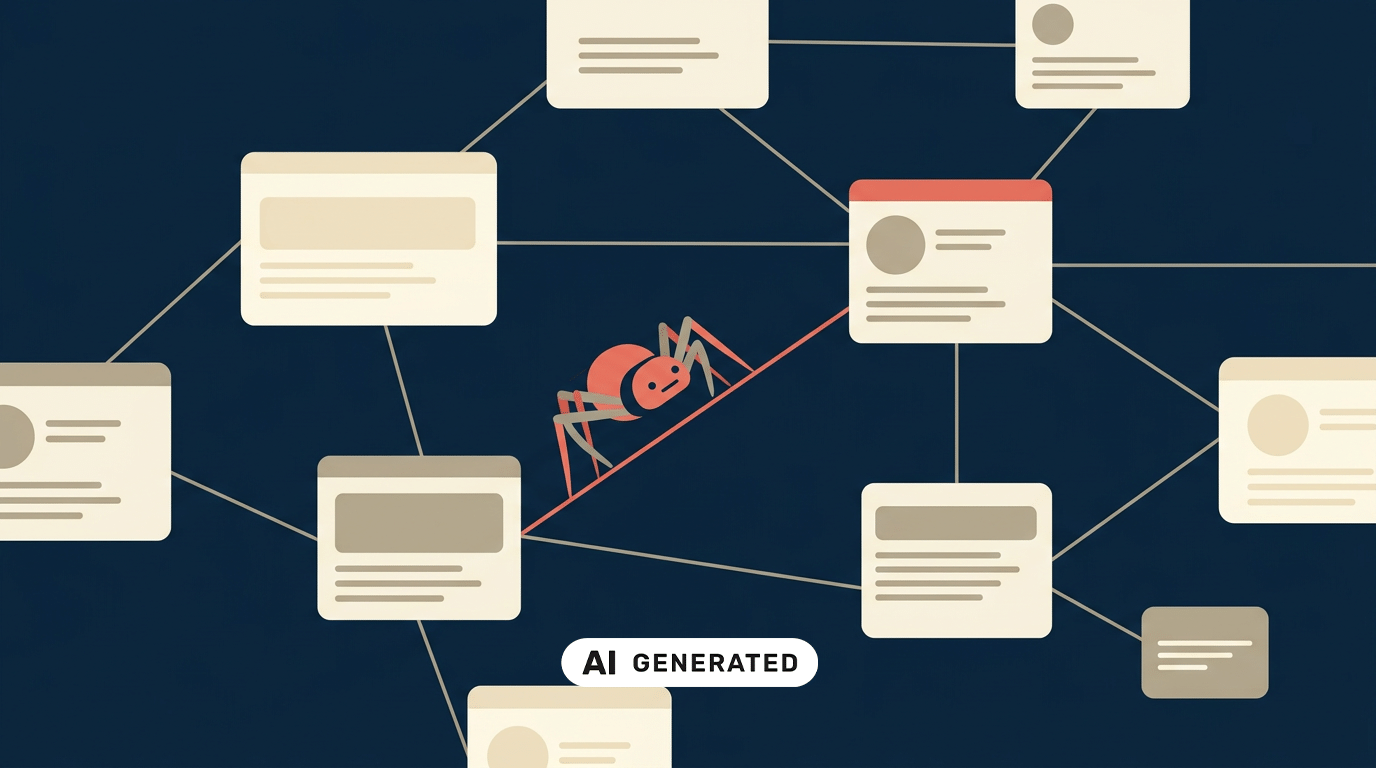
Wenn irgendwo steht, dass ein Unternehmen Websites „crawlt“, klingt das schnell nach einem undurchsichtigen Technikvorgang. Im Kern bedeutet es erst einmal: Eine Software ruft Webseiten automatisiert ab.
Das allein beantwortet aber noch nicht, was mit den abgerufenen Inhalten passiert. Genau deshalb ist die Crawling-Klausel in Metas geplanten Commercial Terms für kleine Unternehmen relevant: Sie beschreibt sowohl den Zugriff auf Websites als auch mögliche Zwecke für die abgerufenen Inhalte. Ich beleuchte dir das Thema unter der Frage, was Web Crawling bei den neuen AGBs von Meta 2026 bedeutet.
Ein Web-Crawler ist ein Programm, das Webseiten automatisiert anfragt. Je nach Aufgabe kann es bekannte URLs abrufen, Links auf einer Seite verfolgen oder gezielt bestimmte Inhalte herunterladen. Suchmaschinen nutzen Crawler zum Beispiel, um Seiten zu entdecken und zu verstehen. Nicht alle Crawler funktionieren gleich.
Stell dir vor, eine Person würde eine Website Seite für Seite öffnen. Ein Crawler erledigt solche Abrufe automatisiert und in viel größerem Umfang. Was genau er anfragt und speichert, hängt davon ab, wer ihn betreibt und wofür er eingesetzt wird.
Die Begriffe werden oft durcheinander verwendet. Vereinfacht gesagt:
Crawling ist das automatisierte Aufrufen und Abrufen von Webseiten.
Scraping bedeutet meist, gezielt Daten oder Inhalte aus den abgerufenen Seiten zu extrahieren.
Indexieren heißt, Informationen zu ordnen und für eine spätere Suche oder Verarbeitung verfügbar zu machen.
Caching bedeutet, Inhalte oder Teile davon vorübergehend zwischenzuspeichern.
In der Praxis können diese Schritte zusammen vorkommen. Aber aus dem Wort „Crawling“ allein kann man nicht ableiten, was mit jedem Text, Bild oder Datensatz später geschieht.
Nein. Der technische Abruf einer Seite und die Nutzung ihrer Inhalte für KI-Training sind unterschiedliche Schritte. Eine Website kann gecrawlt werden, um Informationen zu erfassen oder einen Dienst zu betreiben, ohne dass diese Inhalte zwangsläufig zum Trainieren eines KI-Modells verwendet werden.
Bei Metas geplanter Klausel geht es deshalb um zwei Fragen: Erstens, welche Seiten Meta oder beauftragte Dritte automatisiert abrufen dürfen. Zweitens, welche Zwecke Meta mit den gesammelten Inhalten verfolgen darf.
In der ursprünglichen Fassung der Vorschau stand „train“ ausdrücklich in der Zweckliste. Meta strich dieses Wort später. Die Crawling-Klausel und andere weit gefasste Verben wie „entwickeln“ und „verbessern“ blieben nach späterer Berichterstattung bestehen. Rechtsexpert:innen sahen daher weiterhin offene Auslegungsfragen. Das ist keine sichere Aussage darüber, dass Meta Inhalte einer konkreten Website für KI-Training verwenden wird. Quelle: Nieman Lab.
Die Vorschau der neuen Commercial Terms erlaubt Meta oder einem Dritten in Metas Auftrag, automatisierte Software einzusetzen, um Domains, Webseiten und URLs abzurufen, die mit Produkten oder Dienstleistungen eines Unternehmens verbunden sind. Im Wortlaut kommen auch Test-Zugangsdaten vor. Meta: Vorschau der Commercial Terms
Das bedeutet nicht automatisch, dass Meta Zugriff auf jeden privaten oder geschützten Bereich einer Website hat. Die Klausel sagt, dass Test-Zugangsdaten erstellt werden können; wie das in einem konkreten Fall eingesetzt würde, ist eine andere Frage. Nieman Lab berichtete, Meta habe Fragen dazu, ob damit auch Bezahlschranken oder andere bezahlte Inhalte umgangen würden, nicht beantwortet. Nieman Lab
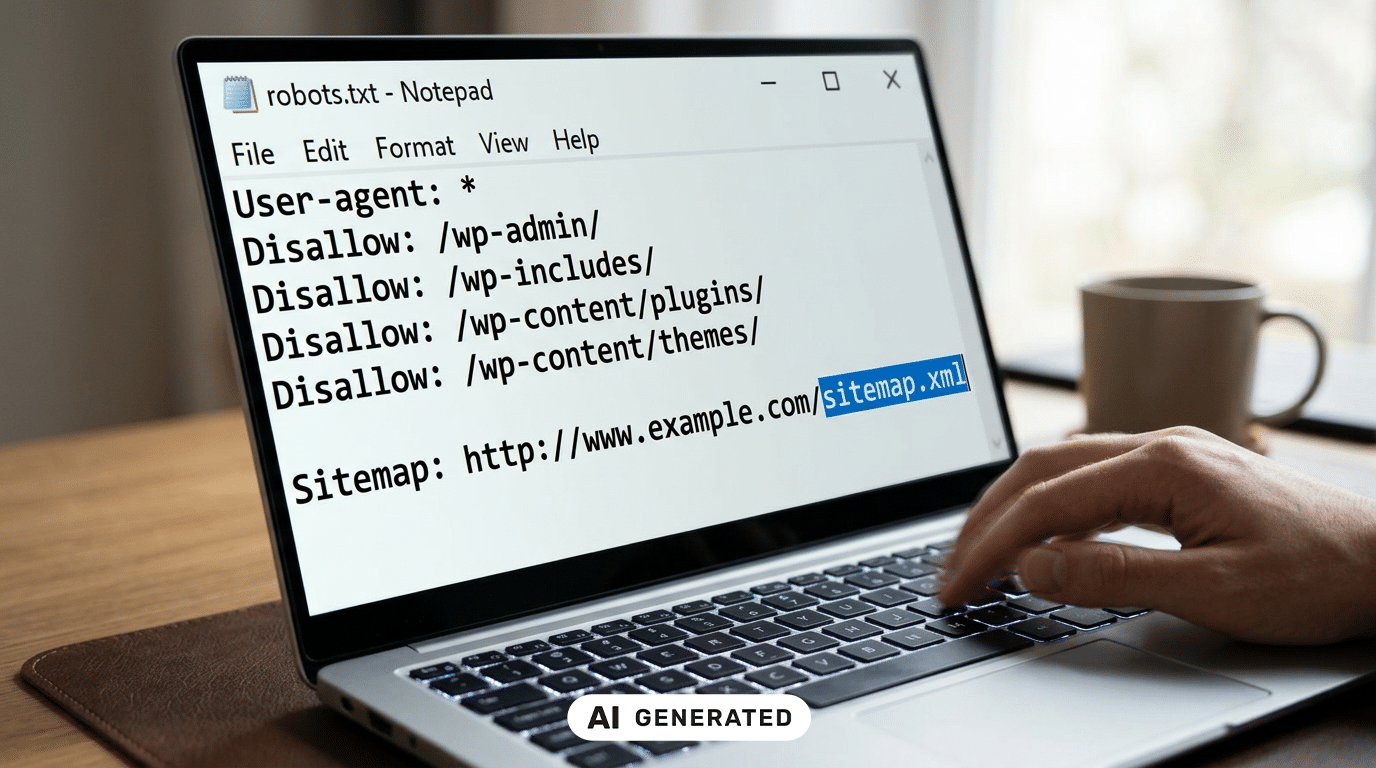
Eine robots.txt-Datei ist eine öffentlich erreichbare Textdatei auf einer Website. Darin kann die Betreiberin oder der Betreiber angeben, welche Bereiche bestimmte Crawler aufrufen sollen oder nicht. Google erklärt, dass die Datei eine Anleitung für Crawler ist. Sie ist keine Zugangssperre wie ein Passwort. Google: robots.txt verständlich erklärt
Meta verwies gegenüber Medien ebenfalls auf robots.txt als Möglichkeit, Crawler zu steuern. Rechtsexpert:innen wiesen darauf hin, dass der Vertragstext diese Zusage nicht ausdrücklich enthält. Das sollte man nicht vermischen: Eine robots.txt kann technisch relevant sein, ist aber nicht automatisch ein vertraglicher Opt-out und garantiert nicht, dass jeder Bot die Anweisung befolgt. Nieman Lab
Crawling bedeutet zunächst automatisierten Abruf, nicht automatisch KI-Training.
Der Vertragstext kann über den Abruf und mögliche Verwendungszwecke sprechen – das sind getrennte Fragen.
robots.txt kann Crawlern eine Anweisung geben, ist aber weder Passwortschutz noch garantiertes Vertrags-Opt-out.
© 2026 All Rights Reserved.