
Tag: 16. November 2026
Meta-AGB 2026: Darf Meta Websites crawlen?
Meta-AGB 2026: Darf Meta Websites crawlen?
-
admin
- Artikelstand: 27. Oktober 2026
Wusstet ihr schon, dass Meta neue Commercial Terms für die geschäftliche Nutzung seiner Produkte plant? Darin steht eine Klausel, die Meta automatisiertes Crawling von Domains, Webseiten und URLs erlaubt, die mit Produkten oder Dienstleistungen eines Unternehmens verbunden sind.
Oder einfach gesagt: Meta will pauschal Zugriff auf alle Daten, die auf der Website sind, die du in deinem Unternehmensaccount verknüpft hast.
Das macht das Thema relevant für alle Unternehmen, die Facebook, WhatsApp Business oder andere Meta-Business-Produkte nutzen.

Inhaltsverzeichnis
Was steht in den neuen Meta-AGB?
Die allgemeinen Geschäftsbedingungen gelten für die geschäftliche oder kommerzielle Nutzung von Meta-Produkten. Die Vorschau der neuen AGBs, die ursprünglich zum 20.10.2026 in Kraft treten sollten, erfasst unter anderem automatisierte Software wie Bots, Scraper und Crawler.
Meta oder ein beauftragter Dritter darf damit Domains, Webseiten und URLs abrufen, die mit den Produkten oder Dienstleistungen eines Unternehmens verbunden sind. Auch Test-Zugangsdaten werden im Wortlaut erwähnt.
Einfach gesagt: Meta beschreibt in den Bedingungen nicht nur, was mit Inhalten passiert, die du direkt auf Facebook oder Instagram veröffentlichst. Die Klausel bezieht sich auch auf Inhalte auf Websites, die mit einem geschäftlichen Auftritt bei Meta verknüpft sein können.
Das ist der Wortlaut der Vertragsvorschau, die mittlerweile NICHT mehr online zu finden ist. Daraus folgt nicht automatisch, dass jede beliebige Website erfasst wird oder dass wir bereits wissen, welche Inhalte Meta tatsächlich abruft. Genau das macht sie so schwierig einzuschätzen – die Begriffe sind schwammig und nicht klar definiert.
Wen kann die Crawling-Klausel betreffen?
Relevant ist die Klausel vor allem für Unternehmen, die Meta-Produkte geschäftlich nutzen. Das kann eine Facebook-Seite sein, ein Werbekonto, ein Produktkatalog oder WhatsApp Business. Entscheidend ist laut Vorschau, ob eine Website mit Produkten oder Dienstleistungen des Unternehmens verbunden ist.
Das kann zum Beispiel die eigene Unternehmenswebsite, ein Blog oder ein Shop sein. Ob eine bestimmte Domain unter die Klausel fällt, lässt sich aber nicht allein daran erkennen, dass irgendwo ein Link zu ihr steht. Zum Beispiel wenn eine Ageentur mehrere URLs verknüpft hat, um so Kundenkonten zu verwalten. In der Vortragsvorschau standen Begriffe wie „associated with“ – auf Deutsch etwa „verbunden mit“ – ist weit und braucht eine sorgfältige Auslegung.
Deswegen lohnt sich die Bestandsaufnahme auch, wenn eine Agentur oder eine andere Person dein Meta-Konto verwaltet: Welche Konten und Domains sind miteinander verknüpft? Wer betreut sie? Und wer kann dir sagen, welche Einstellungen oder Produktkataloge verwendet werden?
Wie hat sich das Thema entwickelt?
Der 15. Oktober war nicht der erste Hinweis auf die Änderung. Es wurden Auszüge von Metas neuen AGBs veröffentlicht, die mittlerweile nicht mehr online sind. Für eine saubere Timeline muss man zwischen Metas Information an Geschäftskonten und der späteren breiteren Berichterstattung unterscheiden – im folgenden bezieh ich mich vor allem auf die breite Berichterstattung, die uns allen zur Verfügung steht.
Anfang Oktober: Meta kündigt ein Update an
Nieman Lab berichtet, Meta habe Geschäftskonten Anfang Oktober in einem Blogbeitrag und in Meta Business Suite über die Aktualisierung informiert. Das Medium wurde nach eigener Darstellung durch einen Hinweis aus der Leserschaft darauf aufmerksam. Nieman Lab: Bericht und Entstehung der Recherche
Eine archivierte Vorschau der Commercial Terms ist spätestens am 5. Oktober 2026 dokumentiert. Das heißt: Informationen über die geplanten Bedingungen waren schon vor dem 15. Oktober öffentlich zugänglich. Archivierte Vorschau vom 5. Oktober
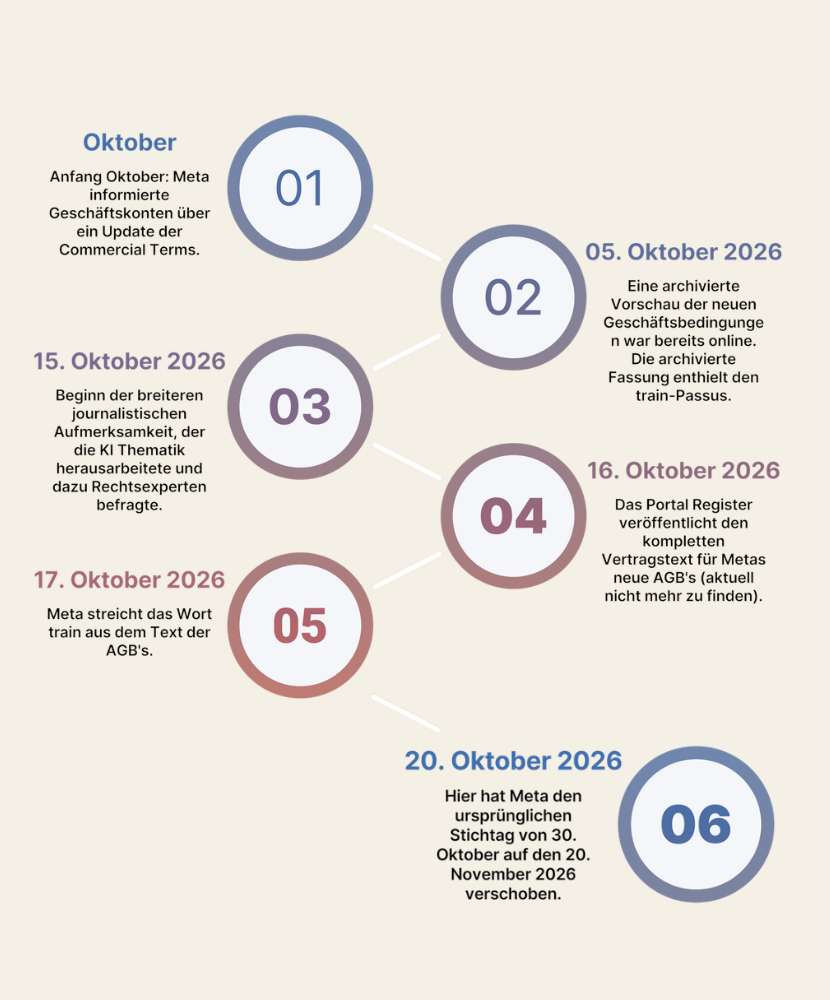
15. Oktober: Nieman Lab ordnet die Crawling-Klausel ein
Am 15. Oktober veröffentlichte Nieman Lab einen Bericht dazu, dass die neuen Bedingungen Meta das Crawling von Websites erlauben könnten, die mit Business-Konten verbunden sind. Das Medium ließ den Wortlaut von Rechtsexpert:innen einordnen. Sie sahen darin unter anderem eine mögliche Grundlage für die Nutzung gesammelter Inhalte in Meta-Produkten und stellten Fragen zu KI-Training und geschützten Inhalten. Das sind rechtliche Einschätzungen, keine abschließende Gerichtsentscheidung. Nieman Lab, 15. Oktober
17. Oktober: Das Wort „train“ verschwindet aus der Klausel
Nach öffentlicher Kritik strich Meta laut späterer Berichterstattung die ausdrückliche Nennung von „train“ aus der Vorschau. Die Crawling-Erlaubnis blieb bestehen; die genannten Zwecke wurden unter anderem auf Werbe- und Geschäftsprodukte bezogen. Rechtsexpert:innen hielten die Reichweite des verbleibenden Wortlauts weiter für auslegungsbedürftig – viel zu auslegungsbedürftig. Nieman Lab zur überarbeiteten Fassung
23. Oktober: Meta verschiebt den geplanten Start auf den 20.11.2026
Meta verschob den geplanten Starttermin vom 30. Oktober auf den 20. November 2026. Als Begründung nannte das Unternehmen mehr Zeit, um Partnern und anderen Beteiligten zu erklären, was sich ändert und was nicht. Die Crawling-Klausel blieb laut Berichterstattung bestehen. Ob öffentlicher Druck der ausschlaggebende Grund für die Verschiebung war, ist nicht belegt. Aber man kann sich hier sicher sein, dass durch die deutschen Gesetze unklar ist, ob Meta hier diese Regeln überhaupt legal umsetzen kann. Es gibt mehr als ein Gesetzt, was dagegenspricht. Unter andere das Urhebergesetzt, die DSGVO und im speziellen das Data-, Mining Gesetz. Nieman Lab zur Verschiebung
Amfang November: Meta verschiebt den geplanten Start erneut
Meta verschiebt den geplanten Starttermin vom 20. November 2026 auf unbestimmte Zeit.
Was bedeutet Crawling – und ist das dasselbe wie KI-Training?
Crawling bedeutet, dass Software Webseiten automatisiert aufruft und Inhalte abruft. Beim Scraping werden aus solchen Seiten gezielt Informationen herausgezogen. Im Alltag werden die Begriffe oft ähnlich verwendet, technisch können sie unterschiedliche Schritte bezeichnen.
Wichtig ist: Eine Website abzurufen ist nicht automatisch dasselbe, wie ihre Inhalte zum Trainieren eines KI-Modells zu verwenden. Was nach dem Abruf mit den Daten geschieht, hängt von den jeweiligen Zwecken und Abläufen ab.
In der ursprünglichen Vertragsvorschau stand das Wort „train“ ausdrücklich in der Liste möglicher Nutzungszwecke. Meta strich es später. Die Begriffe „entwickeln“, „verbessern“ und „erforschen“ blieben jedoch in der Klausel. Kritiker:innen sehen darin weiterhin eine offene Frage. Daraus lässt sich aber nicht sicher ableiten, wofür Meta im Einzelfall konkrete Inhalte nutzen wird.
Was können kleine Unternehmen jetzt prüfen?
Eine pauschale Lösung gibt es nicht. Diese Bestandsaufnahme kann aber helfen abzuwägen, was du tun kannst:
Meta-Nutzung erfassen: Welche Seiten, Werbekonten, Kataloge und Business-Produkte nutzt dein Unternehmen?
Domains zuordnen: Welche Websites, Shops, Blogs oder Landingpages sind damit verbunden? Gibt es eine Agentur oder einen Dienstleister, der Konten verwaltet?
Technik prüfen: Sieh dir an, welche Regeln aktuell in der robots.txt stehen. Das ist eine technische Steuerungsmöglichkeit, aber kein sicherer Ersatz für eine rechtliche Prüfung. Man kann in der robots.txt allerdings explizit die Crawler von der Website anhalten, die die Daten zur Nutzung der KI abgreifen.
Notiz in dern AGBs: Ein maschinenlesbarer Einspruch kann Metas Bots abhalten. Aktuell ist das aber nicht zu 100% sicher.
Konkrete Rechtsfragen klären: Wenn eigene Inhalte einen hohen wirtschaftlichen Wert haben oder du unsicher bist, wende dich an eine qualifizierte Rechtsberatung.
Ich empfehle dir auf jeden Fall, Nr. 3 und 4 umzusetzen. Das bietet grade die höchsten Chancen gegen Metas Crawler. Gesetzlich ist das aber kein 100% Schutz, durch die ganzen Grauzonen.
Fazit
Mich stört vor allem, dass kleine Unternehmen kaum Einfluss auf die Bedingungen einer Plattform haben, von der sie für Werbung oder Kundenkontakt abhängig sein können. Gleichzeitig geht es nicht nur um Inhalte, die wir direkt auf Facebook oder Instagram posten, sondern möglicherweise auch um Inhalte auf der eigenen Website.
Das ist meine Einschätzung. Ich kann nicht behaupten, dass Meta jede verknüpfte Website crawlen oder Inhalte daraus für KI-Training nutzen wird. Aber ich finde, die Vertragsvorschau ist super ungenau, undefiniert und sehr weit gefasst. Nicht umsonst spricht der Rechtsprofessor Goldman von einer „Hobson’s choice“. Eine Zustimmung, die nur über den Verzicht auf eine Plattform erreichbar ist, ist eine schwache Grundlage für die Nutzung fremder Inhalte.
Meta bekommt so Zugriff auf große Mengen aktueller Inhalte, die sonst teuer lizenziert werden müssten. Der Nieman-Lab-Artikel nennt dies eine „Lizenzierung im Millionenwert“ laut dem Juristen Topic (Nieman Journalism Lab)!
Häufige Fragen zu den Meta-AGB
Betrifft die Klausel auch mein privates Facebook-Konto?
Die Commercial Terms beziehen sich auf eine geschäftliche oder kommerzielle Nutzung von Meta-Produkten. Ob ein konkreter Account darunter fällt, hängt von seiner Nutzung und den jeweils geltenden Bedingungen ab. Prüfe den Wortlaut für dein Konto.
Ist Meta-Crawling dasselbe wie KI-Training?
Nein. Crawling beschreibt zunächst das automatisierte Abrufen von Webseiten. Ob abgerufene Inhalte anschließend für KI-Training oder andere Zwecke verwendet werden, ist eine weitere Frage.
Ist die robots.txt ein vertraglicher Widerspruch?
Nein. Die robots.txt ist eine technische Anweisung, KI-Bots davon abzuhalten, die Websitedaten für Meta zu registrieren.
Begriffe und Definitionen
Commercial Terms (kommerzielle Nutzungsbedingungen): Vertragswerk, das Unternehmen akzeptieren, wenn sie Meta-Werbung, Business Suite, Kataloge, Seitenverwaltung oder andere Geschäftsprodukte nutzen. Laut The Register umfasst der Begriff „Geschäftskunden“ alle, die Werbung oder Marketingnachrichten nutzen, Produkte verkaufen oder auflisten, Apps entwickeln, Produktkataloge anlegen, eine Seite verwalten oder Business-Produkte wie Ads Manager oder Meta Business Suite nutzen (The Register).
Web-Scraping / Crawling: Automatisiertes Auslesen von Webseiten durch Software. Ein Crawler folgt Links und lädt Seiten herunter. Ein Scraper extrahiert Inhalte aus Seiten für eine weitere Verwendung.
„Associated with“ (verbunden mit): Der Vertrag erfasst Domains, Webseiten und URLs, die mit den Produkten oder Dienstleistungen der Kundschaft verbunden sind oder über die Nutzung von Meta-Produkten durch sie oder ihre Nutzer:innen zugänglich werden. Der Begriff ist im Vertrag nicht näher definiert. Ob etwa jede verlinkte Website oder nur Seiten mit einem technischen Bezug erfasst sind, lässt sich aus der Vorschau nicht eindeutig ableiten.
Test-Zugangsdaten (test credentials): Die Bedingungen erlauben Meta, Zugangsdaten zu erstellen, um auch Bereiche abzurufen, die eine Registrierung oder Anmeldung erfordern. Der Rechtswissenschaftler Grimmelmann weist darauf hin, dass dies auch Zugang zu geschützten Bereichen ermöglichen könnte (Colombia One).
robots.txt: Eine Textdatei im Hauptverzeichnis einer Website, in der Betreiber Crawlern mitteilen, welche Bereiche sie abrufen dürfen. Die Datei ist ein Standard und keine technische Zugriffssperre. Bots können sie ignorieren (Kollektive Intelligenz).
Meta-ExternalAgent und Meta-ExternalFetcher: Zwei Crawler-Bezeichnungen, die Meta nach Berichten des Entwicklerportals DEV dokumentiert. Der ExternalAgent sammelt laut Dokumentation Daten für das Training von Basismodellen und für die Indexierung. Der ExternalFetcher ruft einzelne Links auf Anfrage einer Nutzerin oder eines Nutzers ab und hat eine eigene robots.txt-Ausnahme. Diese Angaben konnte ich nicht direkt an der Meta-Dokumentation prüfen, weil die Seite nicht abrufbar war (DEV Community).
KI-Training: Verwendung von Inhalten, um KI-Modelle zu trainieren oder zu verbessern. Ob und wie das im Einzelfall stattfindet, ist aus dem Vertragstext nicht sicher ablesbar.
Opt-out / Nutzungsvorbehalt: Erklärung des Rechteinhabers, dass er einer bestimmten Nutzung seiner Inhalte nicht zustimmt. Im deutschen Recht ist dafür bei online zugänglichen Werken eine maschinenlesbare Form erforderlich (siehe Kapitel 5).
© 2026 All Rights Reserved.